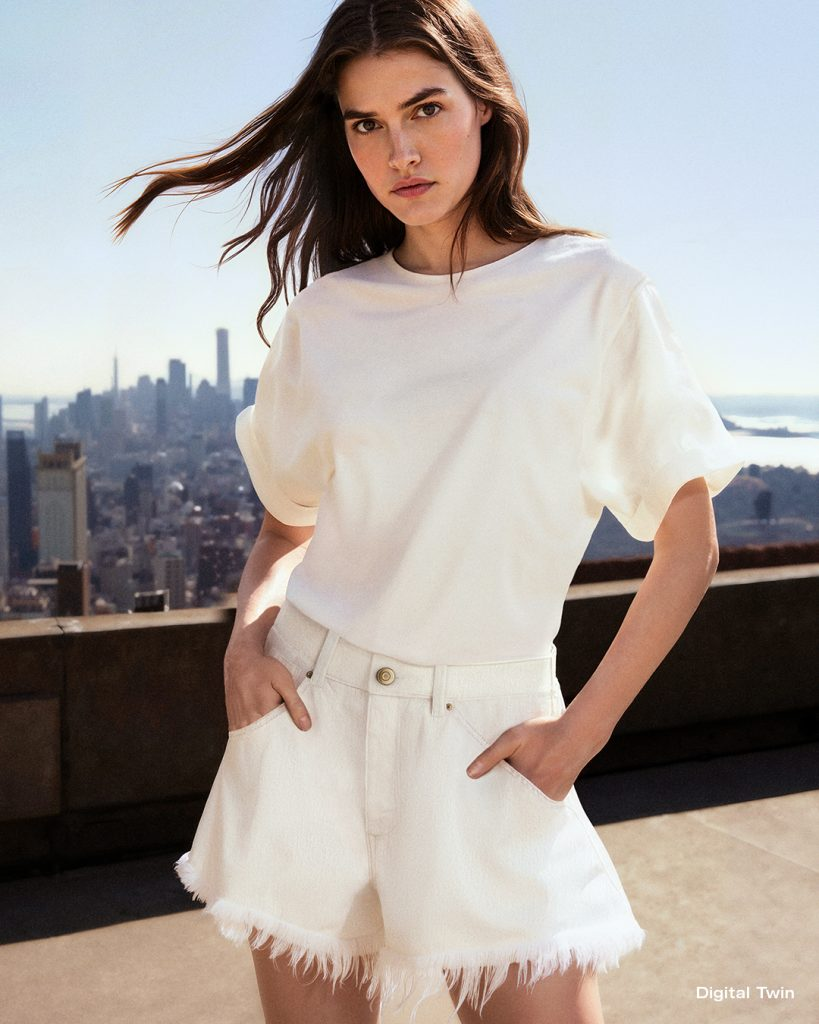
Изображение с цифровым двойником H&M, июль 2025 года. Источник: H&M Group. Изображение создано с применением генеративного ИИ; пометка Digital Twin сохранена.
В нижней части изображения из кампании H&M за июль 2025 года стоит небольшая надпись «Digital Twin». Над ней человек в белой футболке и светлых шортах на фоне городского пейзажа. Волосы уложены набок. Всё выглядит непринуждённо, как обычно и бывает в кадре, где за эту непринуждённость уже кто-то отвечал.
Пометка меняет вопрос. Вместо «Где это снято?» хочется спросить: «А что здесь вообще снимали?»
В своём сообщении H&M назвала эту серию первой публикацией изображений с цифровыми двойниками. Над ней работала команда, в которую входили фотограф и модель. Это конкретный проект конкретной компании, а не доказательство того, что вся модная фотография за ночь стала другой. Из пресс-релиза также нельзя узнать все условия договоров, размеры гонораров и то, на что именно согласился каждый участник. Для этого нужно отдельное исследование.
Но сама картинка заставляет задуматься. Слово «ИИ» может скрывать очень разную работу. Сгенерированный фон, воссозданная внешность человека и нарисованная алгоритмом одежда требуют разных пояснений. Общая пометка сообщает об участии ИИ, но не обязательно объясняет, что именно он сделал. Для начала полезно. Примерно как сообщение в меню о том, что еду готовили.
В моде у этой разницы есть вполне практический смысл. Мы можем спокойно принять невозможный пейзаж в рекламе и при этом рассчитывать, что рукав на картинке выглядит так же, как тот, который можно купить. Складка на локте могла появиться при движении, быть специально уложена для съёмки или сгенерирована. В каждом случае она сообщает об одежде что-то своё.
Здесь становится важна история происхождения файла. Стандарт C2PA позволяет прикреплять сведения о создании и изменениях изображения, заверенные цифровой подписью. Content Credentials помогают обнаружить, не была ли такая запись изменена. Но они не доказывают правдивость изображённой сцены и не гарантируют справедливых условий работы. Отсутствие этих данных тоже не означает, что картинка сгенерирована.
Поэтому у технических данных и обычной подписи разные задачи. Первые помогают проследить зафиксированные этапы обработки и узнать, кто их заверил. Подпись должна человеческим языком объяснить, на что мы смотрим. Будет обидно подробно описать, как создавалось изображение, а потом спрятать это описание за формулировкой, которой самой нужна расшифровка.
С согласием участников нужна такая же ясность. Разрешение создать цифрового двойника ещё не означает согласия использовать его в любой ситуации. Одобрение одной кампании тоже не обязательно распространяется на её будущие варианты. Об этом нужно спрашивать участников. Готовая картинка за них не ответит.
Для смелой фантазии в модной рекламе вполне есть место. Для вопроса «А брюки действительно так сидят?» тоже. Эти интересы прекрасно уживаются.
Любопытно, сколько сведений о создании останется с изображением, когда оно покинет страницу бренда. При кадрировании, перепубликации или создании скриншота мелкий текст в углу легко теряется. Хорошо, если пометка сохраняется и в этих версиях изображения. А если нет, у зрителя должен остаться понятный способ найти подробный рассказ о том, как оно сделано.